Web sitenizi ziyaret eden yapay zeka tarayıcıları, içeriğinizi büyük dil modellerinin eğitim havuzuna aktarmak veya kullanıcılara anlık yanıtlar sunarken kaynak göstermek amacıyla sayfalarınızı inceler. robots.txt dosyanızda bu botları ayrım gözetmeksizin engellemek, telif haklarınızı koruyor gibi görünse de markanızı ChatGPT, Perplexity ve Gemini gibi platformların tavsiye listelerinden tamamen silebilir. Doğru dengeyi kurmak, içeriğinizi izinsiz model eğitiminden korurken yapay zekâ destekli aramalarda görünür kalmanızı sağlayan seçici bir tarama mimarisinden geçer.
Yapay zeka tarayıcıları nedir ve web sitelerinde ne arar?
Yapay zeka tarayıcıları, büyük dil modellerini (LLM) geliştiren teknoloji şirketlerinin web sitelerindeki metin, görsel ve yapısal verileri toplamak için kullandığı otomatik bot yazılımlarıdır. Bu botlar geleneksel Googlebot veya Bingbot gibi çalışsa da topladıkları veriyi dizine ekleme biçimleri ve kullanım amaçları farklıdır.
Yapay zekâ sistemleri temel olarak iki farklı veri toplama sürecine ihtiyaç duyar: devasa modellerin temel eğitimi (pre-training) ve kullanıcının anlık sorusuna yanıt üretirken yapılan web araması (RAG - Retrieval-Augmented Generation). Birinci gruptaki botlar internetin genelini tarayarak modellerin dil algısını ve bilgi hazinesini genişletir. İkinci gruptaki botlar ise kullanıcının girdiği bir sorgu anında web sitenize gelip en güncel fiyatı, ürün bilgisini ya da hizmet detayını okur ve kullanıcıya kaynak bağlantısıyla birlikte bir yanıt derler.
Sitenizi ziyaret eden en yaygın yapay zekâ ajanları şunlardır:
- GPTBot: OpenAI tarafından modellerin gelecekteki sürümlerini eğitmek üzere geniş ölçekli web verisi toplamak için kullanılır.
- ChatGPT-User: ChatGPT içerisinde kullanıcılar arama yaptığında veya internette gezinme özelliği tetiklendiğinde sayfayı gerçek zamanlı ziyaret eden arama botudur.
- PerplexityBot: Perplexity arama motorunun dizinini güncel tutan ve kullanıcı sorularına canlı kaynak sağlayan taranma aracıdır.
- Google-Extended: Google'ın Gemini ve diğer yapay zekâ araştırma modellerini eğitmek için içerik toplamasına yarayan özel kullanıcı aracısıdır (User-agent).
- ClaudeBot / Anthropic-ai: Anthropic tarafından geliştirilen Claude modellerinin eğitiminde kullanılan içerik tarayıcısıdır.
Model eğitimi yapan botlar ile canlı arama botları arasındaki fark
Model eğitimi yapan botlar içeriğinizi modellerin kalıcı hafızasına kazımak için toplarken, canlı arama botları kullanıcının o anda sorduğu soruya web sitenizden kaynak göstererek doğrudan cevap vermek amacıyla sitenizi ziyaret eder. İki bot türü arasındaki bu ayrımı anlamadan robots.txt dosyanızı düzenlemek, organik büyümenizi telafisi güç bir çıkmaza sokabilir.
Model eğitimi amacıyla çalışan botlar içeriğinizi alır; ancak bu işlem sitenize doğrudan tıklama veya trafik kazandırmaz. Buna karşılık, canlı arama ve yanıt botları modern GEO (Generative Engine Optimization) ekosisteminin can damarıdır. Bir kullanıcı ChatGPT veya Perplexity üzerinde sektörünüzle ilgili bir tavsiye aradığında, arama botu web sitenize erişemezse model sitenizdeki bilgileri doğrulayamaz ve sizi rakibinizin yerine önermez. Dolayısıyla eğitim botlarıyla yanıt botlarını birbirinden ayırmak şarttır.
| Bot Adı | Temsil Ettiği Platform | Birincil Görevi | Engellenirse Ne Olur? |
|---|---|---|---|
| GPTBot | OpenAI | Gelecek modeller için veri eğitimi | OpenAI modelleri sitenizdeki yeni veriyi öğrenemez; ancak canlı arama hemen kesilmez. |
| ChatGPT-User | OpenAI (SearchGPT / ChatGPT Search) | Kullanıcı sorgularına canlı web yanıtı sağlama | ChatGPT kullanıcılara sitenizden doğrudan alıntı yapamaz ve kaynak linki veremez. |
| PerplexityBot | Perplexity AI | Yanıt dizini oluşturma ve anlık arama | Perplexity cevaplarında markanız önerilmez, arama sonuçlarında kaynak gösterilmezsiniz. |
| Google-Extended | Gemini ve yapay zekâ ürünlerinin eğitimi | Gemini eğitiminden içerikleriniz çıkarılır; klasik Google Arama sıralamaları etkilenmez. | |
| ClaudeBot | Anthropic | Claude modelleri için veri toplama | Claude modelleri sitenizi doğrudan eğitim kümesinde kullanamaz. |
Özellikle Perplexity optimizasyonu rehberi incelendiğinde görülecektir ki, PerplexityBot gibi canlı yanıt indeksleyicilerini engellemek, markanın yeni nesil yanıtlarda görünür olmasını tamamen imkânsız kılar.
robots.txt dosyasında yapay zekayı engellemenin görünürlüğe etkileri
robots.txt dosyanızda yapay zekâ tarayıcılarını topyekûn engellemek, markanızın yapay zekâ destekli platformlardaki görünürlüğünü sıfıra indirir. Bu engelleme, klasik arama motoru dizininden silinmekle eşdeğer bir dijital görünmezlik riski doğurur.
Günümüzde tüketiciler satın alma kararlarını Google'da onlarca bağlantıya tıklayarak vermek yerine doğrudan yapay zekâ asistanlarına sorarak şekillendiriyor. Bir potansiyel müşteri "En güvenilir kurumsal filo kiralama firmaları hangileri?" veya "İstanbul'da diş implantı için hangi klinikler öneriliyor?" diye sorduğunda, yapay zekâ yanıt motorları gerçek zamanlı bir tarama gerçekleştirir. Sitenizin robots.txt dosyasında yer alan genel bir engelleme kuralı şu sonuçları doğurur:
- Kaynak Gösterilememe: Yapay zekâ cevap üretirken markanızın adını bilse dahi web sitenizi kaynaklar arasında referans veremez ve tıklanabilir bağlantı ekleyemez.
- Yanlış veya Eksik Bilgi Yayılımı: Botlar güncel fiyat listenizi, hizmet kapsamınızı veya iletişim bilgilerinizi okuyamadığı için kullanıcıya eski veya rakipleriniz üzerinden türetilmiş kulaktan dolma bilgiler sunabilir.
- Tavsiye Sıralamalarında Geriye Düşme: Yapay zekâ modelleri taranabilir, yapılandırılmış ve güvenilirliği web üzerinden anlık teyit edilen kaynakları önceliklendirir. Taranmayan bir site güvenilirlik puanında geriye düşer.
Tüketicilerin neden geleneksel arama motorları yerine yapay zekâya yöneldiğini anlamak için yapay zekada önerilmek konusundaki dönüşümü iyi analiz etmek gerekir. Karar vericilerin kullandığı araçlar değiştiğinde, tarama politikalarınızın bu yeni düzene ayak uydurması zorunludur.
Yapay zeka tarayıcılarını engellemeli misiniz, yoksa izin mi vermelisiniz?
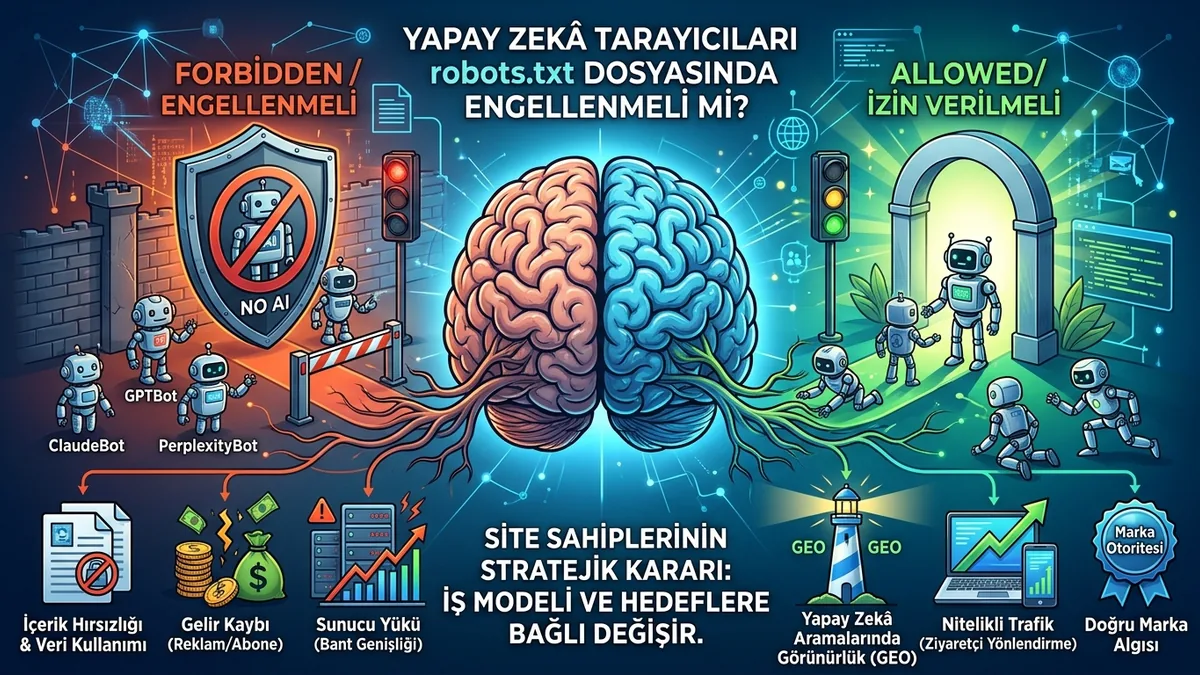
Yapay zekâ tarayıcılarını toptan engellemek yerine, yayınladığınız içeriğin türüne ve iş modelinizin hedeflerine göre seçici bir izin stratejisi uygulamalısınız. Her markanın veri değeri, telif hassasiyeti ve müşteriye ulaşma kanalları birbirinden farklıdır.
İşletmenizin türüne göre uygulamanız gereken stratejiler şu şekildedir:
- Hizmet Sektörü, E-Ticaret ve B2B Şirketleri: Amacınız daha fazla müşteriye ulaşmak ve satış yapmaktır. Bu nedenle ChatGPT-User, PerplexityBot ve Googlebot gibi canlı yanıt botlarına kesinlikle izin vermelisiniz. Model eğitimi yapan GPTBot gibi araçlara izin vermek de markanızın LLM'lerin uzun vadeli kavram hafızasına yerleşmesini sağlar.
- Özgün İçerik Üreten Yayıncılar ve Medya Siteleri: İçeriğiniz doğrudan para kazandığınız nihai ürün ise (örneğin abonelikle çalışan haber siteleri, özel araştırma raporları), model eğitimi yapan botları (GPTBot, ClaudeBot, Google-Extended) engelleyebilirsiniz. Ancak arama trafiğini kaybetmemek adına canlı arama botlarını açık bırakmak yararınıza olacaktır.
- Hassas Veri Barındıran Platformlar: Kullanıcı panelleri, özel dokümantasyonlar veya telifli eğitim materyalleri robots.txt düzeyinde tüm botlara tamamen kapatılmalıdır.
Paro Medya olarak çalıştığımız markalarda en sık gördüğümüz durum, teknik ekiplerin veri güvenliği refleksiyle robots.txt dosyasına eklediği tek satırlık genel kısıtlamaların, pazarlama ekibinin aylarca verdiği görünürlük emeğini bir gecede baltalamasıdır. Rakiplerinizin ChatGPT yanıtlarında neden sizden önce önerildiğini merak ediyorsanız, ilk kontrol etmeniz gereken yer teknik tarama izinlerinizdir. Bu kaybın boyutunu ölçmek için yapay zeka rakip analizi adımlarını uygulayabilirsiniz.
robots.txt dosyasında yapay zeka botları nasıl yapılandırılır?
robots.txt dosyanızda her yapay zekâ aracını ayrı bir User-agent başlığı altında tanımlayarak hem model eğitimini sınırlandırabilir hem de canlı arama botlarına tam erişim tanıyabilirsiniz. Bu hibrit yapı, içeriğinizin izinsiz modellerce kopyalanmasını önlerken GEO performansınızı en üst seviyede tutar.
Aşağıda modern bir web sitesi için uygulanabilecek iki temel yapılandırma örneği yer almaktadır:
1. Model Eğitimini Kısıtlayan, Canlı Arama ve GEO'ya İzin Veren robots.txt Modeli
Bu senaryoda içeriğinizin genel yapay zekâ eğitim havuzuna bedelsiz girmesini engeller, fakat kullanıcılar ChatGPT ya da Perplexity üzerinden arama yaptığında sitenizin tavsiye edilmesine izin verirsiniz:
User-agent: *
Allow: /

# Model Eğitimi Yapan Botlar (Engellendi)
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Bytespider
Disallow: /

# Canlı Yanıt ve Arama Botları (İzin Verildi)
User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /
2. Maksimum GEO Görünürlüğü Sağlayan Tam Açık Model
Özellikle büyümek isteyen KOBİ'ler, yerel işletmeler ve kurumsal B2B markaları için tavsiye edilen bu modelde tüm yapay zekâ ajanlarına açık kapı bırakılır:
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

Sitemap: https://www.siteadiniz.com/sitemap.xml
Sitenizin taranma altyapısını güçlendirirken yalnızca robots.txt ile yetinmemelisiniz. Yapay zekâ botlarının sitenizi çok daha temiz ve bağlamsal okuyabilmesi adına geliştirilen llms.txt kurulumu standartlarını hayata geçirmek, verinizin modeller tarafından doğru işlenmesini kolaylaştırır. Ayrıca genel altyapınızın taranabilirlik sağlığını denetlemek için teknik SEO kontrol listesi yönergelerinden faydalanabilirsiniz.
robots.txt haricinde yapay zekâ botları nasıl yönetilir?
robots.txt dosyasının yanı sıra HTTP yanıt üstbilgileri, WAF (Web Application Firewall) kuralları ve sayfa içi meta etiketleri kullanarak yapay zekâ taraması üzerinde çok daha hassas bir denetim kurabilirsiniz. Çünkü robots.txt yalnızca saygın botların uyduğu bir protokol niteliğindedir; kötü niyetli veri kazıyıcılar bu kuralları göz ardı edebilir.
Uygulayabileceğiniz ek yönetim katmanları şunlardır:
- Cloudflare ve Güvenlik Duvarı Filtreleri: Cloudflare gibi güvenlik ağları, 'AI Scrapers and Crawlers' kategorisi altındaki botları tek tıkla engellemenize veya yönetmenize izin verir. Burada dikkat edilmesi gereken nokta, faydalı arama botlarının da bu filtreye takılıp takılmadığını log kayıtlarından izlemektir.
- Sunucu Kaynak Tüketimi (Rate Limiting): Bazı yapay zekâ botları sitenizi çok agresif tarayarak sunucu yanıt sürelerinizi yavaşlatabilir. Web sunucunuzda (Nginx, LiteSpeed, Apache) yapay zekâ botlarının IP bloklarına özel hız sınırlamaları tanımlayarak altyapınızı koruyabilirsiniz.
- No-AI Meta Etiketleri: Bazı içerik üreticileri sayfa kodlarına
robotsmeta etiketiyle birliktenoaiveyanoimageaidirektifleri ekleyerek metin ve görsellerin yapay zekâ modellerine aktarılmasını kısıtlamayı tercih etmektedir.
Yapay zekâ ekosistemi statik bir yapı değildir; her hafta yeni bir arama modeli veya tarayıcı ajan piyasaya çıkmaktadır. Bu nedenle sunucu erişim loglarınızı düzenli aralıklarla inceleyerek sitenizi hangi botların ziyaret ettiğini ve bu botların dönüşüm sağlayıp sağlamadığını periyodik olarak doğrulamalısınız.
Paro Medya ile yapay zekâda önerilme ve bot yönetim sürecinizi planlayın
Yapay zekâ tarayıcılarını doğru yönetmek, markanızı hem gereksiz veri sömürüsünden korur hem de ChatGPT, Gemini ve Perplexity gibi platformlarda rakiplerinizin önüne geçiren bir tavsiye mıknatısına dönüştürür. Paro Medya, Türkiye'nin ilk GEO ajansı olarak markanızın yapay zekâ ekosisteminde kusursuz taranmasını ve aramalarda doğrudan önerilmesini sağlar.
Paro Medya, tarama mimariniz ve yapay zekâ görünürlüğünüz için şu adımları eksiksiz yürütür:
- Kapsamlı Bot ve Tarama Mimarisi Denetimi: Web sitenizin robots.txt, sunucu logları ve güvenlik duvarı kuralları detaylıca taranarak markanızı yapay zekâ arama motorlarından gizleyen tüm teknik engeller ortadan kaldırılır.
- GEO Odaklı İçerik ve llms.txt Entegrasyonu: Yapay zekâ botlarının içeriğinizi kolayca okuyup doğrulaması için siteniz yeni nesil bilgi mimarisine, yapısal verilere ve llms.txt standartlarına kavuşturulur.
- Çok Kanallı Model Takibi: Markanızın ChatGPT, Perplexity, Gemini ve Google AI Overviews sorgularında sektörünüzle ilgili aramalarda nasıl tavsiye edildiği Paro AI destekli algoritmalarla sürekli izlenir.
- Kişiselleştirilmiş Yol Haritası: Siteniz ve hedeflediğiniz anahtar kelimeler uzman ekibimiz tarafından analiz edilir; en geç 2 iş günü içinde işletmenize özel şeffaf strateji teklifi hazırlanır.
- Müşteri Paneli Üzerinden Canlı İzleme: Yapılan tüm teknik düzenlemeler, içerik geliştirmeleri ve aylık performans raporları size tahsis edilen özel panel üzerinden adım adım şeffaf biçimde sunulur.
Yapay zekâ aramalarında markalar ortalama 3-4 ayda öneri listelerinde istikrarlı biçimde görünmeye başlar. Botlarınızı doğru yapılandırarak GEO çalışmalarınızı başlatmak için GEO ajansı hizmeti sayfamızı inceleyebilir, web sitenizin mevcut durumunu görmek için ücretsiz SEO + GEO testi yapabilir ya da vakit kaybetmeden ekibimizden ücretsiz analiz ve teklif alabilirsiniz.