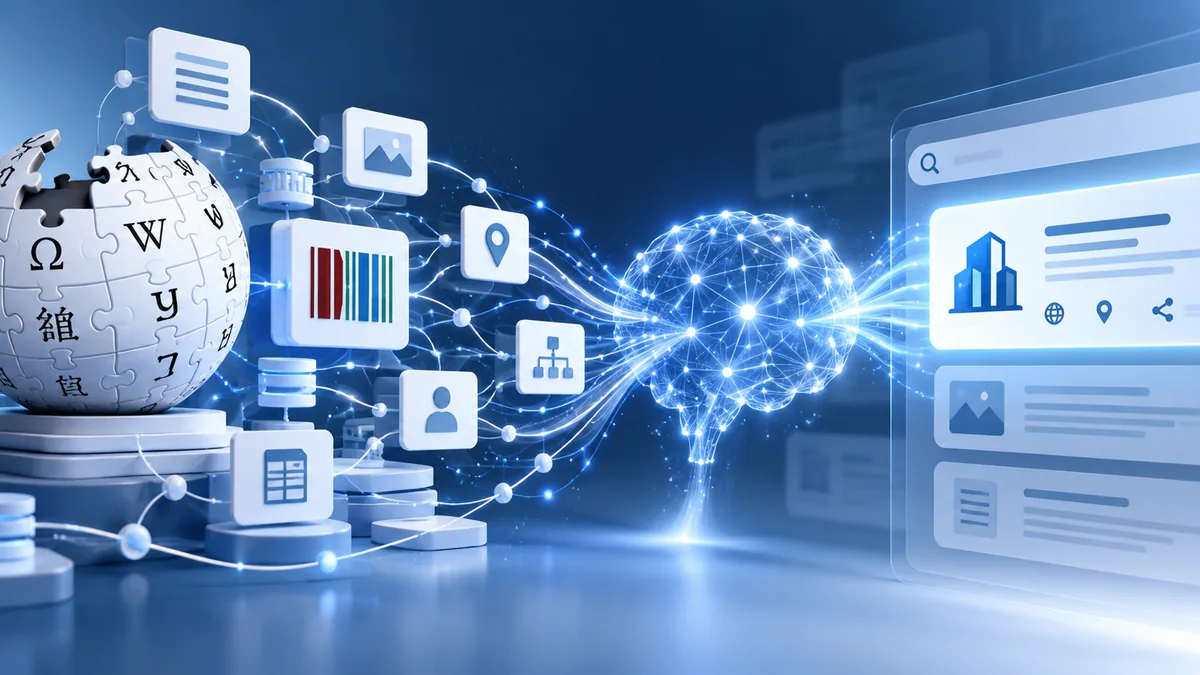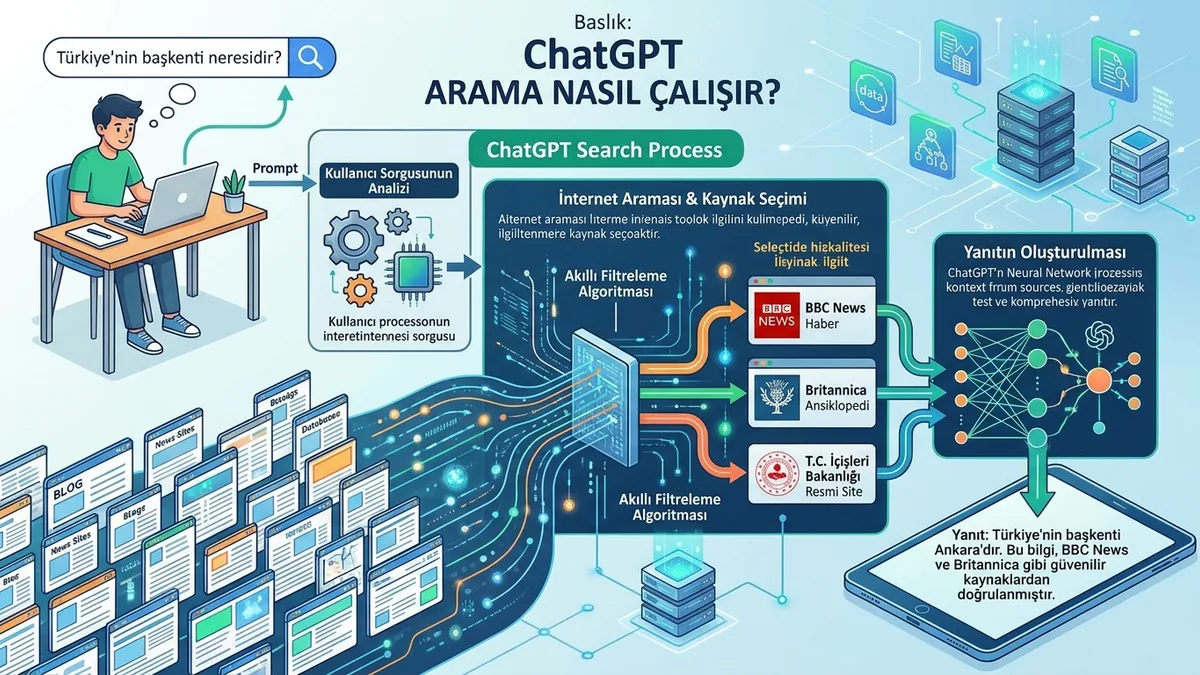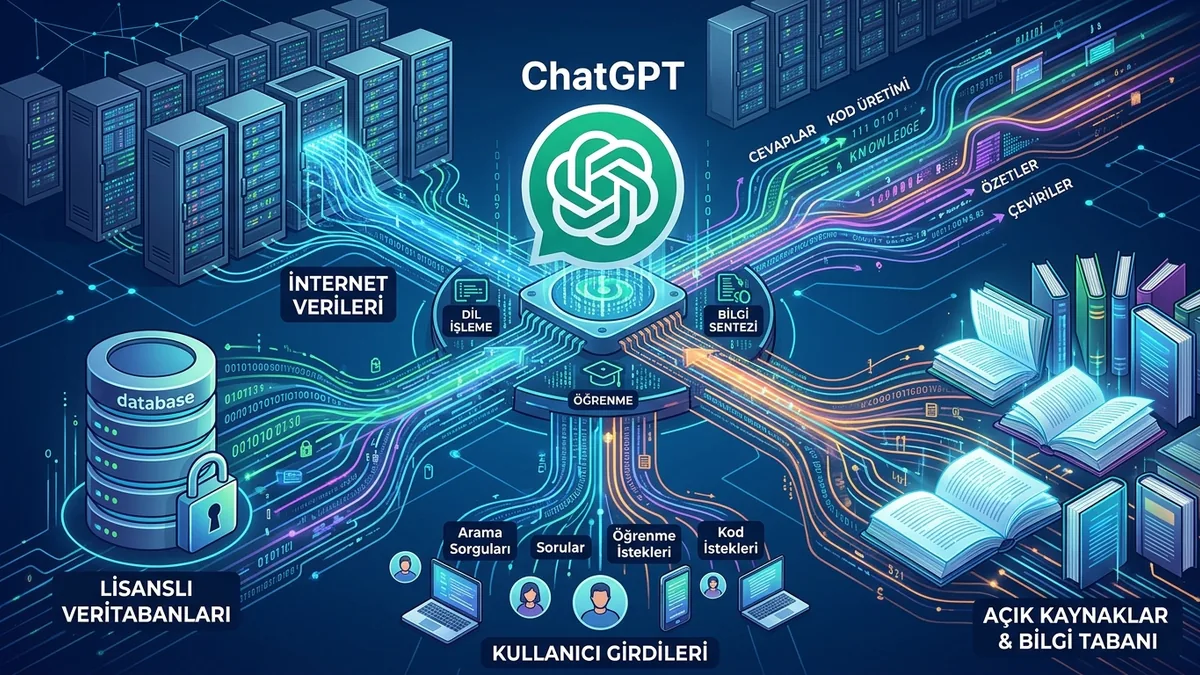
ChatGPT kaynakları temel olarak üç ana sütundan beslenir: modelin eğitim aşamasında taranan devasa açık web arşivleri, özel anlaşmalarla sağlanan lisanslı veri tabanları ve kullanıcı sorularına gerçek zamanlı yanıt vermek için gerçekleştirilen anlık arama motoru taramaları. Yapay zekâ, bu verileri geleneksel bir kütüphane gibi depolamak yerine matematiksel ağırlıklar ve anlamsal ilişkiler zinciri olarak zihninde tutar. Bu sayede bir kullanıcı soru sorduğunda, doğrudan tek bir sayfayı kopyalamaz; taranan binlerce kaynağın sentezini yaparak özgün bir yanıt üretir.
Dijital dünyada varlık gösteren işletmeler ve içerik üreticileri için bu kaynakların neler olduğunu bilmek, yapay zekâ yanıtlarında yer almanın ilk kuralıdır. Kullanıcılar artık yalnızca Google'da arama yapmıyor; ürün tavsiyelerinden teknik problem çözümlerine kadar her şeyi doğrudan yapay zekâ asistanlarına soruyor. Markanızın bu yanıtlarda güvenilir bir öneri olarak öne çıkabilmesi, yapay zekânın taradığı kaynak ekosisteminde doğru konumlanmanıza bağlıdır.
ChatGPT bilgi mimarisi: Model veriyi nasıl öğrenir ve hatırlar?
ChatGPT, bilgiyi geleneksel bir veri tabanı gibi satır satır saklamaz; metinler arasındaki istatistiksel ve anlamsal bağlantıları "parametre" adı verilen ağırlıklar üzerinden öğrenir. OpenAI tarafından geliştirilen büyük dil modelleri (LLM), ön eğitim (pre-training) sürecinde milyarlarca sayfalık dijital içeriği okur. Bu süreçte kelimelerin hangi bağlamlarda yan yana geldiği, kavramların birbirleriyle ilişkisi ve dilin gramer yapısı kavranır.
Ön eğitim sonrasında insan geri bildirimiyle pekiştirmeli öğrenme (RLHF) aşamasına geçilir. Bu aşamada insan eğitmenler, modelin ürettiği yanıtları doğruluk, tarafsızlık, üslup ve güvenlik kriterlerine göre puanlar. Böylece model, öğrendiği ham veriyi mantıklı, anlaşılır ve yardımsever bir diyalog formatında sunma yeteneği kazanır. ChatGPT bir soruya yanıt verirken hafızasındaki milyarlarca parametreyi tetikler ve en yüksek olasılığa sahip, en tutarlı kelime dizilimini inşa eder.
Temel ChatGPT kaynakları: Modelin beslendiği ana veri katmanları
ChatGPT kaynakları tek bir havuzdan ibaret değildir; modelin güvenilirliğini, derinliğini ve güncelliğini sağlayan farklı katmanların birleşiminden oluşur. OpenAI, eğitim modellerinde hangi verilerin kullanıldığını genel çerçevesiyle açıklar ve bu mimari dört ana bileşene dayanır:
1. Açık web taramaları ve kamuya açık arşivler
İnternetin kamuya açık alanları, modelin genel dünya bilgisini edindiği temel kaynaktır. Common Crawl gibi kamuya açık devasa web arşivleri, modelin dünyadaki dilleri, kültürleri, bilimsel kavramları ve gündelik konuşma kalıplarını öğrenmesinde büyük rol oynar. Blog yazıları, rehberler, haber siteleri, ürün açıklamaları ve forumlar bu tarama ağının parçasıdır.
2. Yapılandırılmış bilgi tabanları ve ansiklopediler
Modelin doğrulanabilir olguları hatasız öğrenebilmesi için yapılandırılmış veri kaynaklarına öncelik verilir. Wikipedia, dijital kütüphaneler ve açık kaynaklı ontolojiler yapay zekânın en sık başvurduğu omurgadır. Özellikle bir kavramın ya da markanın kim olduğunu netleştirmek için Wikidata ve bilgi grafiklerinin yapay zekâ görünürlüğü etkisi kritik bir rol oynar. Yapay zekâ, bir varlığın güvenilirliğini bu kaynaklardaki net tanımlar üzerinden teyit eder.
3. Lisanslı veri ortaklıkları ve yayıncı anlaşmaları
OpenAI, eğitim verilerinin kalitesini artırmak ve telif tartışmalarını aşmak adına dünyanın önde gelen medya grupları, akademik arşivleri ve içerik platformlarıyla stratejik lisans anlaşmaları yapar. Büyük haber ajansları, bilimsel dergiler ve köklü yayın organlarının arşivleri doğrudan modele entegre edilir. Bu anlaşmalar, ChatGPT'nin yalnızca amatör web içeriklerine değil, editöryal süzgeçten geçmiş güvenilir yayınlara da dayanmasını sağlar.
4. Kod depoları ve teknik dokümantasyonlar
ChatGPT'nin yazılım dillerini öğrenmesi, kod üretmesi ve teknik sorunları çözmesi için GitHub gibi açık kaynaklı kod depoları ve resmi teknik dokümantasyonlar taranır. Bu kaynaklar, modelin mantıksal akıl yürütme becerisini ve adım adım problem çözme yeteneğini önemli ölçüde güçlendirir.
Canlı arama ve web tarama: ChatGPT internete nasıl bağlanır?
ChatGPT, yalnızca geçmiş eğitim verisiyle sınırlı kalmaz; güncel olaylar, anlık fiyatlar veya yerel öneriler sorulduğunda arama motoru altyapısını kullanarak canlı web taraması yapar. Kullanıcının sorusu statik bilginin ötesine geçtiğinde, sistem arka planda Bing arama motorunu devreye sokar ve arama sonuçlarındaki en alakalı web sayfalarını saniyeler içinde analiz eder.
Bu canlı tarama sürecinde OpenAI'ın web tarayıcı botları (özellikle GPTBot ve OAI-SearchBot) siteleri ziyaret eder. Eğer siteniz bu botların erişimine açıksa ve kullanıcıların aradığı soruya net, yapılandırılmış bir yanıt sunuyorsa, ChatGPT yanıt metninin içine web sitenizi kaynak linki olarak ekler. Yapay zekâ asistanlarının kaynak seçim mekanizmasını daha iyi kavramak için Perplexity'de kaynak olma rehberi ve arama devinin benzer mantıkla çalışan sistemi olan Google AI Overviews kaynak seçimi stratejilerini incelemek, çok kanallı bir görünürlük planı için oldukça faydalıdır.
| Veri Katmanı | Kapsam ve İçerik Türü | Güncellik Düzeyi | Marka İçin Önemi |
|---|---|---|---|
| Ön Eğitim Verileri | Açık web, kitaplar, arşivler, kamuya açık siteler | Periyodik model güncellemelerine bağlı | Marka bilinirliği ve temel sektör tanımları |
| Yapılandırılmış Veriler | Wikipedia, Wikidata, akademik bilgi grafikleri | Düzenli işlenen doğrulanmış veri tabanları | Güvenilirlik, tüzel varlık netliği, sektörel otorite |
| Lisanslı Yayıncı Ağları | Küresel haber ajansları, saygın medya kuruluşları | Sürekli entegre edilen kaliteli içerikler | Tarafsız basın yansımaları ve kurumsal itibar |
| Canlı Arama (SearchBot) | Güncel web sayfaları, bloglar, haberler, forumlar | Gerçek zamanlı (anlık indeks ve arama) | Anlık önerilme, ürün/hizmet tavsiyesi ve trafik akışı |
ChatGPT hangi kaynaklara daha çok güvenir?
ChatGPT, bulduğu her web sayfasını eşit derecede güvenilir kabul etmez; bilginin teyit edilebilirliğine, alan adı otoritesine ve dijital ayak izinin tutarlılığına bakar. Yapay zekâ sistemleri için bir kaynağın güvenilir sayılmasında temel ölçütler şunlardır:
- Çapraz Doğrulama (Konsensüs): Bir bilgi internet genelinde birden fazla bağımsız ve saygın kaynak tarafından doğrulanıyorsa, model o bilginin doğruluğuna daha yüksek olasılık atar. Tek bir blogda geçen iddialar model tarafından şüpheyle karşılanabilir.
- Yapılandırılmış Veri Mimarisi: Schema.org işaretlemeleri, açık ve hiyerarşik HTML yapıları modelin bir sayfadaki veriyi hatasız ayrıştırmasını sağlar. Kimin konuştuğu, ürünün ne olduğu ve yazarın uzmanlığı kod düzeyinde net olmalıdır.
- Dijital Ekosistem Tutarlılığı: Bir markanın iletişim bilgileri, sunduğu hizmetler ve fiyat politikası kendi sitesinde, Google Haritalar'da, sektörel dizinlerde ve basın bültenlerinde birebir aynı olmalıdır. Çelişkili bilgiler yapay zekânın kafasını karıştırır.
Paro Medya olarak çalıştığımız markalarda en sık gördüğümüz durum, firmanın web sitesi teknik olarak kusursuz görünse bile dijital ekosistemdeki tutarsız veriler nedeniyle yapay zekâ tarafından referans gösterilmekten kaçınılmasıdır. Yapay zekâ, güven seviyesi düşük veriyi kullanıcısına önermek istemez. Eğer asistanlar sektörünüzle veya firmanızla ilgili hatalı çıkarımlar yapıyorsa, yapay zekâ yanlış bilgi verdiğinde izlenecek adımlar üzerinden bu veri kirliliğini sistematik olarak temizlemek gerekir.
Markanız ChatGPT kaynakları arasına nasıl girer?
Markanızın ChatGPT yanıtlarında bir kaynak veya önerilen firma olarak yer alması tesadüf değildir; planlı bir Üretken Motor Optimizasyonu (GEO) çalışması gerektirir. Sitenizi yapay zekâ için güvenilir bir referans noktası haline getirmek için şu adımları izlemelisiniz:
- Bot İzinlerini Eksiksiz Yapılandırın: Web sitenizin
robots.txtdosyasındaGPTBot,OAI-SearchBotve arama motoru botlarının engellenmediğinden emin olun. Taranamayan sayfalar canlı yanıtlara kaynak olamaz. - Sorulara İlk Paragrafta Doğrudan Yanıt Verin: ChatGPT pasaj odaklı tarama yapar. Bir başlık altındaki ilk iki cümle konuyu net bir tanımla özetliyorsa, yapay zekâ bu metni doğrudan alıntılamayı tercih eder.
- Sektörel Otorite ve Basın Görünürlüğü Kazanın: Markanız hakkında saygın sektörel portallarda, haber mecralarında ve tarafsız inceleme platformlarında yer alan içerikler, yapay zekânın sizi bir sektör lideri olarak etiketlemesini sağlar. Nitekim ChatGPT'de markanızın önerilmemesi genellikle bu tür üçüncü taraf dijital referans eksikliklerinden kaynaklanır.
- Varlık (Entity) Olarak Konumlanın: Firmanızı salt bir web sitesi olarak değil, açıkça tanımlanmış bir tüzel varlık olarak tanıtın. Kurucular, adres, uzmanlık alanları ve tescilli markalar gibi unsurları açıkça sergileyin. Bu yaklaşım firmanızın ChatGPT'de adım adım çıkması için en temel gerekliliktir.
Paro Medya ile yapay zekâda önerilme sürecinizi yönetin
Yapay zekâ asistanlarının kaynak havuzuna girmek ve sektörünüzdeki potansiyel müşterilerinize doğrudan tavsiye edilmek, yeni nesil bir arama görünürlüğü stratejisi gerektirir. Paro Medya, Türkiye'nin ilk GEO ajansı olarak markanızın ChatGPT, Gemini, Perplexity ve Google AI Overviews gibi platformlarda en doğru kaynaklar üzerinden öne çıkmasını sağlar.
Paro Medya, yapay zekâ görünürlük yolculuğunuzda şu çalışmaları eksiksiz olarak yürütür:
- LLM Kaynak ve Bot Taraması: Web sitenizin GPTBot, PerplexityBot ve Google-Extended gibi yapay zekâ tarayıcılarına teknik uygunluğunu ve taranabilirlik durumunu inceler.
- Varlık (Entity) ve Semantik Bilgi Tasarımı: Markanızı dijital bilgi grafiklerine ve yapılandırılmış veri katmanlarına entegre ederek yapay zekânın sizi birincil otorite olarak tanımasını sağlar.
- Çapraz Ekosistem Tutarlılığı: İnternet genelinde markanız hakkında yer alan tüm veri kaynaklarını denetler, çelişkileri giderir ve yapay zekânın güven skorunu maksimize eder.
- Soru-Cevap Odaklı GEO Mimarisi: Potansiyel müşterilerinizin yapay zekâya yönelttiği sektörel soruları tespit eder ve sitenizi bu soruların doğrudan alıntılanan yanıtı olacak şekilde yapılandırır.
- Müşteri Paneli ve Şeffaf Raporlama: Markanıza özel panel üzerinden sitenizde atılması gereken teknik ve editoryal adımları adım adım iletir; her ay düzenli görünürlük raporları sunar.
Çalışma modelimiz tamamen şeffaf ve analize dayalıdır. Web sitenizi ve hedeflediğiniz anahtar kelimeleri bize ilettiğinizde (başvuru formundaki üç kelime yalnızca ön analiz içindir, hizmetimiz kelime sayısıyla kısıtlı değildir), Paro AI ve uzman kadromuz kelimelerin rekabet düzeyini ve sitenizin eksiklerini çıkarır. En geç 2 iş günü içinde işletmenize özel ayrıntılı bir teklif hazırlayarak sunarız; sistemimizde hazır paket uygulaması bulunmaz.
Yapay zekâ görünürlüğü sürekli devam eden bir süreçtir ve markalarımız ortalama 3-4 ay içerisinde asistan önerilerinde görünmeye başlar. Yapay zekâ dönüşümüne hazır olup olmadığınızı görmek için ücretsiz 12 soruluk SEO ve GEO hazırlık testini tamamlayabilir, markanızın yapay zekâda güvenle tavsiye edilmesi için ücretsiz analiz ve teklif formunu doldurarak profesyonel GEO ajansı desteği alabilirsiniz.